
哈希表
介绍
哈希表 是基于 链表 实现的,所以速度要比 数组 快的多
哈希化
为了把字符串转化为对应的下标值,需要有一套编码系统.
为了方便理解我们创建这样一套编码系统: 比如 a 为 1,b 为 2,c 为 3,以此类推 z 为 26,空格为 27 ( 不考虑大写情况 ) .
有了编码系统后,将字母转化为数字也有很多种方案:
方案一: 数字相加
例如 cats 转化为数字: 3 + 1 + 20 + 19 = 43,那么就把 43 作为 cats 单词的下标值储存在数组中
但是这种方式会存在这样的问题: 很多的单词按照该方式转化为数字后都是 43,比如 was. 而在数组中一个下标值只能储存一个数据,所以该方式不合理.
方案二: 幂的连乘
我们平时使用的大于 10 的数字,就是用幂的连乘来表示它的唯一性的. 比如: 6543 = 6 * 10^3 + 5 * 10^2 + 4 * 10 + 3 这样单词也可以用该种方式来表示: cats = 3 * 27^3 + 1 * 27^2 + 20 * 27 + 17 = 60337.
虽然该方式可以保证字符的唯一性,但是如果是较长的字符 ( 如 aaaaaaaaaa ) 所表示的数字就非常大,此时要求很大容量的数组,然而其中却有许多下标值指向的是无效的数据 ( 比如不存在 zxcvvv 这样的单词 ) ,造成了数组空间的浪费.
两种方案总结:
- 第一种方案 ( 让数字相加求和 ) 产生的数组下标太少.
- 第二种方案 ( 与 27 的幂相乘求和 ) 产生的数组下标又太多.
现在需要一种压缩方法,把幂的连乘方案系统中得到的 巨大整数范围压缩到可接受的数组范围中 . 可以通过 取余 操作来实现. 虽然取余操作得到的结构也有可能重复,但是可以通过其他方式解决.
地址冲突
拉链法
如下图所示,我们将每一个数字都对 10 进行取余操作,则余数的范围 0~9 作为数组的下标值. 并且,数组每一个下标值对应的位置存储的不再是一个数字了,而是存储由经过取余操作后得到相同余数的数字组成的数组或链表.
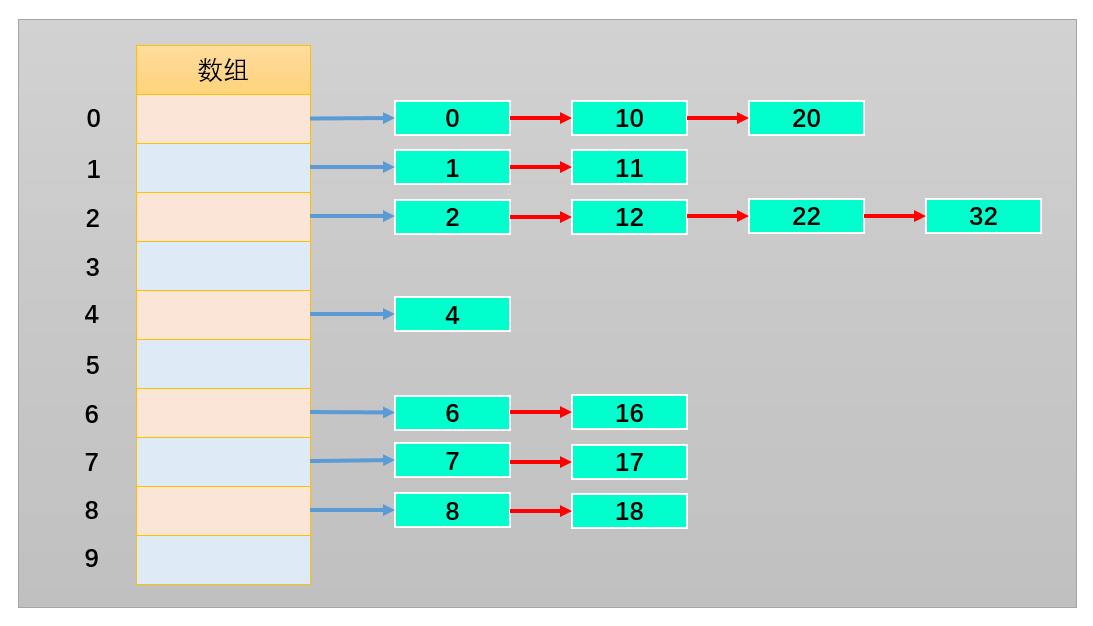
这样可以根据下标值获取到整个数组或链表,之后继续在数组或链表中查找就可以了. 而且,产生冲突的元素一般不会太多.
总结: 链地址法解决冲突的办法是每个数组单元中存储的不再是单个数据,而是一条链条,这条链条常使用的数据结构为数组或链表,两种数据结构查找的效率相当 ( 因为链条的元素一般不会太多 ) .
开放地址法
开放地址法的主要工作方式是寻找空白的单元格来放置冲突的数据项.
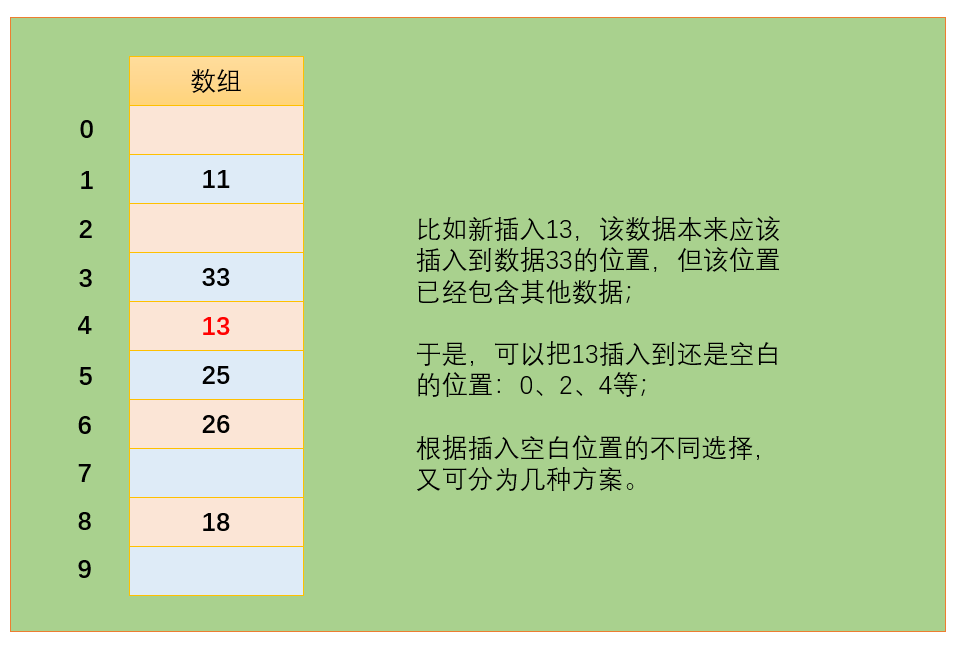
根据探测空白单元格位置方式的不同,可分为三种方法:
- 线性探测
- 二次探测
- 再哈希法
线性探测
- 当插入
13时:
经过哈希化 ( 对 10 取余 ) 之后得到的下标值 index=3 ,但是该位置已经放置了数据 33 . 而线性探测就是从 index 位置+1 开始向后一个一个来查找合适的位置来放置 13,所谓合适的位置指的是空的位置,如上图中 index=4 的位置就是合适的位置.
当查询
13时:- 首先
13经过哈希化得到index=3,如果index=3的位置存放的数据与需要查询的数据13相同,就直接返回 不相同时,则线性查找,从index+1位置开始一个一个位置地查找数据13 - 查询过程中不会遍历整个哈希表,只要查询到空位置,就停止,因为插入
13时不会跳过空位置去插入其他位置.
- 首先
当删除
13时:- 删除操作和上述两种情况类似,但需要注意的是,删除一个数据项时,不能将该位置下标的内容设置为
null,否则会影响到之后其他的查询操作,因为一遇到为null的位置就会停止查找. - 通常删除一个位置的数据项时,我们可以将它进行特殊处理 ( 比如设置为
-1) ,这样在查找时遇到-1就知道要继续查找.
- 删除操作和上述两种情况类似,但需要注意的是,删除一个数据项时,不能将该位置下标的内容设置为
线性探测存在的问题:
线性探测存在一个比较严重的问题,就是聚集.
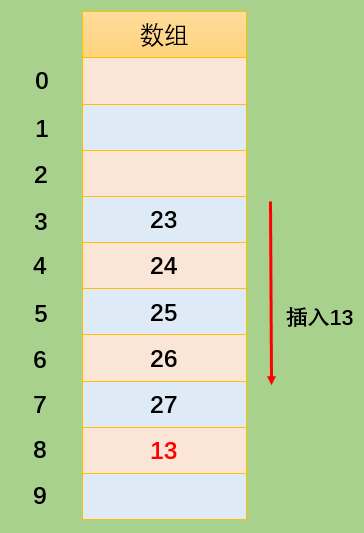
如哈希表中还没插入任何元素时,插入
2324252627,这就意味着下标值为34567的位置都放置了数据,这种一连串填充单元就称为聚集.聚集会影响哈希表的性能,无论是插入/查询/删除都会影响.
比如插入
13时就会发现,连续的单元3~7都不允许插入数据,并且在插入的过程中需要经历多次这种情况. 二次探测法可以解决该问题.
二次探测
上文所说的线性探测存在的问题:
如果之前的数据是连续插入的,那么新插入的一个数据可能需要探测很长的距离
二次探测是在线性探测的基础上进行了优化:
线性探测: 我们可以看成是步长为 1 的探测,比如从下表值 x 开始,那么线性探测就是按照下标值:
x+1x+2x+3等依次探测二次探测: 对步长进行了优化,比如从下标值 x 开始探测:
x+1^2^x+2^2^x+3^2^. 这样一次性探测比较长的距离,避免了数据聚集带来的影响.二次探测存在的问题:
当插入数据分布性较大的一组数据时,比如:
13-163-63-3-213,这种情况会造成步长不一的一种聚集 ( 虽然这种情况出现的概率较线性探测的聚集要小 ) ,同样会影响性能.
再哈希法
在开放地址法中寻找空白单元格的最好的解决方式为再哈希化
- 二次探测的步长是固定的:
1,4,9,16依次类推 - 现在需要一种方法: 产生一种依赖关键字(数据)的探测序列,而不是每个关键字探测步长都一样
- 这样,不同的关键字即使映射到相同的数组下标,也可以使用不同的探测序列
- 再哈希法的做法为: 把关键字用另一个哈希函数,再做一次哈希化,用这次哈希化的结果作为该关键字的步长
第二次哈希化需要满足以下两点:
- 和第一个哈希函数不同,不然哈希化后的结果仍是原来位置
- 不能输出为
0,否则每次探测都是原地踏步的死循环
优秀的哈希函数:
stepSize = constant - (key % constant)- 其中 constant 是质数,且小于数组的容量
- 例如:
stepSize = 5 - (key % 5),满足需求,并且结果不可能为0
哈希化的效率
哈希表中执行插入和搜索操作效率是非常高的.
- 如果没有发生冲突,那么效率就会更高
- 如果发生冲突,存取时间就依赖后来的探测长度
- 平均探测长度以及平均存取时间,取决于填装因子,随着填装因子变大,探测长度会越来越长.
装填因子
- 装填因子表示当前哈希表中已经包含的数据项和整个哈希表长度的比值
- 装填因子 = 总数据项 / 哈希表长度
- 开放地址法的装填因子最大为
1,因为只有空白的单元才能放入元素 - 链地址法的装填因子可以大于
1,因为只要愿意,拉链法可以无限延伸下去
不同探测方式性能的比较
线性探测
可以看到,随着装填因子的增大,平均探测长度呈指数形式增长,性能较差. 实际情况中,最好的装填因子取决于存储效率和速度之间的平衡,随着装填因子变小,存储效率下降,而速度上升.
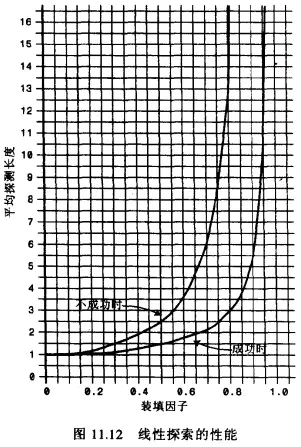
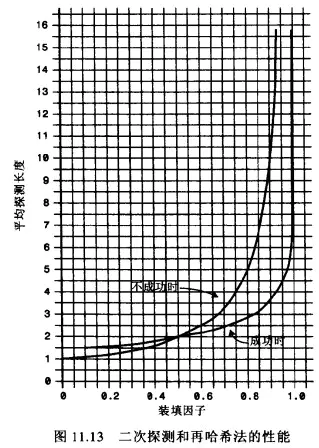
二次探测和再哈希化的性能
二次探测和再哈希法性能相当,它们的性能比线性探测略好. 由下图可知,随着装填因子的变大,平均探测长度呈指数形式增长,需要探测的次数也呈指数形式增长,性能不高.
链地址法的性能
可以看到随着装填因子的增加,平均探测长度呈线性增长,较为平缓. 在开发中使用链地址法较多,比如
Java中的HashMap中使用的就是链地址法.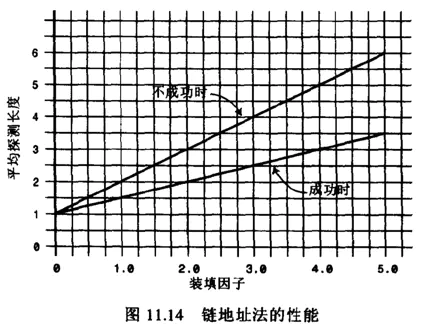
哈希函数
哈希表的优势在于它的速度,所以哈希函数不能采用消耗性能较高的复杂算法. 提高速度的一个方法是在哈希函数中尽量减少乘法和除法.
性能高的哈希函数应具备以下两个优点:
- 快速的计算
- 均匀的分布
快速计算
霍纳法则: 在中国霍纳法则也叫做秦久韶算法,具体算法为:
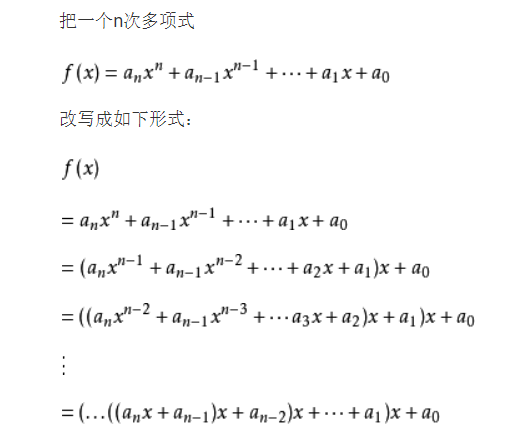
求多项式的值时,首先计算最内层括号内一次多项式的值,然后由内向外逐层计算一次多项式的值. 这种算法把求 n 次多项式 f(x) 的值就转化为求 n 个一次多项式的值.
变换之前:
- 乘法次数:
n(n+1)/2次 - 加法次数:
n次
- 乘法次数:
变换之后:
- 乘法次数:
n次 - 加法次数:
n次
- 乘法次数:
如果使用大 O 表示时间复杂度的话,直接从变换前的 O(N^2) 降到了 O(N)
均匀分布
在设计哈希表时,我们已经有办法处理映射到相同下标值的情况: 链地址法或者开放地址法. 但是,为了提供效率,最好的情况还是让数据在哈希表中均匀分布. 因此,我们需要在使用常量的地方,尽量使用质数. 比如: 哈希表的长度,N 次幂的底数等.
Java 中的 HashMap 采用的是链地址法,哈希化采用的是公式为: index = HashCode(key) & (Length-1) 即将数据化为二进制进行与运算,而不是取余运算. 这样计算机直接运算二进制数据,效率更高. 但是 JavaScript 在进行较大数据的与运算时会出现问题,所以我们使用 JavaScript 实现哈希化时采用取余运算.
TS 实现
import { DoublyLinkedList } from './双向链表.js'

class HashTable {
  #storage: DoublyLinkedList<[string, any]>[] = [] // 数组存储元素
  #length = 0 // 当前存放了多少个元素
  #limit = 9 // 总个数
  #constant = 37 // 常量
  #minPrecent = 0.25 // 最小百分比
  #maxPrecent = 0.75 // 最大百分比

  constructor(limit = 9, minPrecent = 0.25, maxPrecent = 0.75) {
    this.#limit = limit
    this.#minPrecent = minPrecent
    this.#maxPrecent = maxPrecent
  }

  #hashFunc(value: string): number {
    let hashCode = 0

    for (let i = 0; i < value.length; i++) {
      hashCode = this.#constant * hashCode + value.charCodeAt(i)
    }

    return hashCode % this.#limit
  }

  #indexOfName(list: DoublyLinkedList<[string, any]>, key: string): number {
    const size = list.size()

    for (let i = 0; i < size; i++) {
      const [success, value] = list.get(i)
      if (!success || value.getValue()[0] !== key) {
        continue
      }

      return i
    }

    return -1
  }

  // 保证哈希表的长度是质数
  #getPrime(num: number): number {
    if (num <= 2) {
      return 2
    }

    let isPrime = true
    for (let i = 2; i <= Math.sqrt(num); i++) {
      if (num % i === 0) {
        isPrime = false
        break
      }
    }

    if (isPrime) {
      return num
    }

    return this.#getPrime(num + 1)
  }

  #resize(newLimit: number): boolean {
    const oldStorage = this.#storage

    this.#limit = this.#getPrime(newLimit)
    this.#storage = []
    this.#length = 0

    oldStorage.forEach((bucket) => {
      const size = bucket.size()

      for (let i = 0; i < size; i++) {
        const [success, bucketValue] = bucket.get(i)
        if (!success) {
          continue
        }

        const [key, value] = bucketValue.getValue()
        this.put(key, value)
      }
    })

    return true
  }

  put(key: string, value: any): boolean {
    const hashCode = this.#hashFunc(key)

    let bucket = this.#storage[hashCode]
    if (!bucket) {
      bucket = new DoublyLinkedList()
      this.#storage[hashCode] = bucket
    }

    const index = this.#indexOfName(bucket, key)

    if (index === -1) {
      if (this.#length > this.#limit * this.#maxPrecent) {
        this.#resize(this.#limit * 2)
      }

      bucket.append([key, value])
      this.#length++
    }
    else {
      bucket.update(index, [key, value])
    }

    return true
  }

  get(key: string): [true, any] | [false, null] {
    const hashCode = this.#hashFunc(key)

    const bucket = this.#storage[hashCode]
    if (!bucket) {
      return [false, null]
    }

    const size = bucket.size()
    if (size === 0) {
      return [false, null]
    }

    const index = this.#indexOfName(bucket, key)
    if (index === -1) {
      return [false, null]
    }

    const [success, value] = bucket.get(index)
    if (!success) {
      return [false, null]
    }

    return [true, value.getValue()[1]]
  }

  remove(key: string): boolean {
    const hashCode = this.#hashFunc(key)

    const bucket = this.#storage[hashCode]
    if (!bucket) {
      return false
    }

    const size = bucket.size()
    if (size === 0) {
      return false
    }

    const index = this.#indexOfName(bucket, key)
    if (index === -1) {
      return false
    }

    const success = bucket.removeAt(index)
    if (!success) {
      return false
    }

    this.#length--

    if (
      this.#limit > 9
      && this.#length < this.#limit * this.#minPrecent
    ) {
      this.#resize(Math.floor(this.#limit / 2))
    }

    return true
  }

  isEmpty() {
    return this.#length === 0
  }

  size() {
    return this.#length
  }
}